مسئلهای که باید حل میکردم
کمترین کارت همیشه بهترین حمایت از شریک نیست. اگر حریف هنوز بازی نکرده و میتواند حکم بزند، ظاهرِ برد فعلی نباید ربات را مطمئن کنه.
پیادهسازی در نسخهٔ فعلی
HokmAdvancedBotTacticalStrategy.ChooseCard مسیر شروع دور، جلو بودن شریک و جلو بودن حریف را جدا میکنه. ScoreSupportDiscardCard و ScoreWinningCard به حافظه، پایان دست و نزدیکی امتیاز توجه دارن.
تصمیم و هزینهٔ طراحی
CountUnknownHigherCardsInSuit کارتهای دیدهشده و دست خود ربات را کنار میگذارد. OpponentYetToActCanTrump از علامت خال خالی و باقیماندن حکم برای خطر زدن استفاده میکنه.
مرزهای فعلی
اینها امتیازهای ابتکاریاند و مدل احتمال کامل یا یادگیری ماشین نیستند. کلاس پیشرفته باید در مسیر فعال صحنه هم بررسی بشه؛ وجود آن بهتنهایی اثبات استفاده از همهٔ شاخهها نیست.
ارزیابی آسیبپذیری کارت برنده
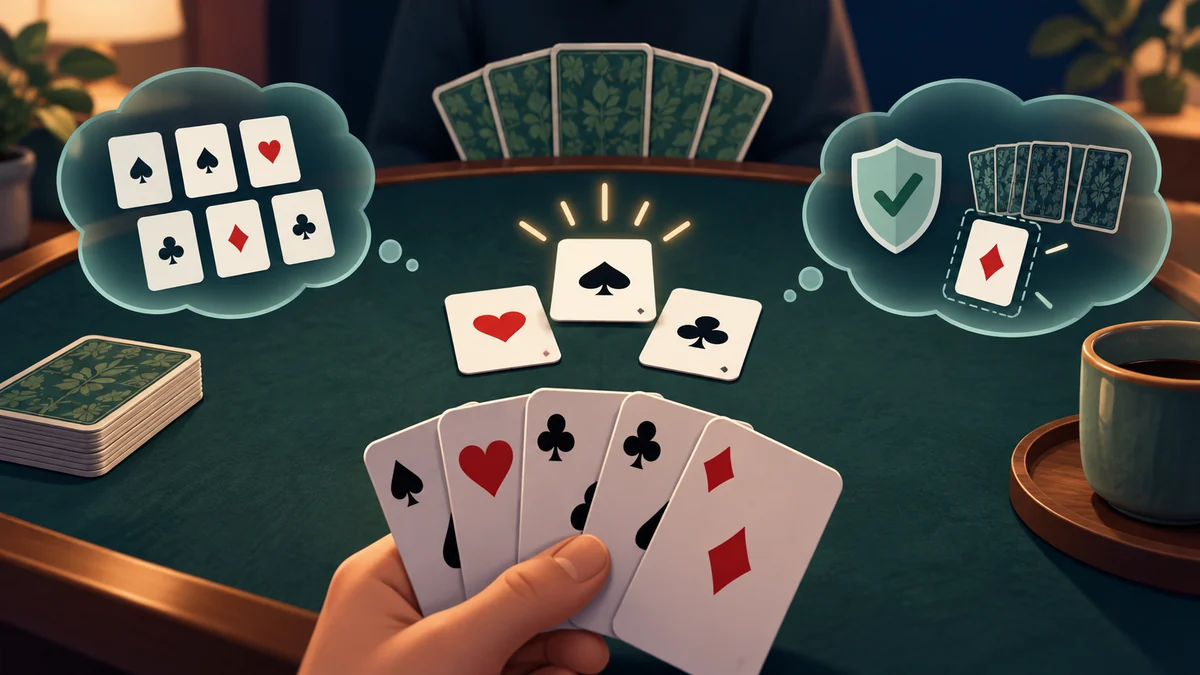
یک کارت میتواند همین حالا دور را ببرد ولی برای نفر بعد آسیبپذیر باشد. ScoreWinningCard امتیاز اولیه را از LowestWinningCardBonus منهای GetPowerCost میسازد، سپس برای آخرین نفر بودن، برد با حکم کوچک و برندهٔ محافظتشده تغییر میدهد. در مقابل، VulnerableWinnerPenalty و هزینهٔ مصرف حکم بالای زودهنگام میتوانند انتخاب را پایین بکشند. این وزنها ترجیحهای قابل تنظیم هستند، نه احتمال برد محاسبهشده. انتخاب نهایی حاصل مقایسهٔ امتیازهای ابتکاری هست؛ هیچ عددی در این کد بهتنهایی نرخ موفقیت واقعی بات را اثبات نمیکنه.
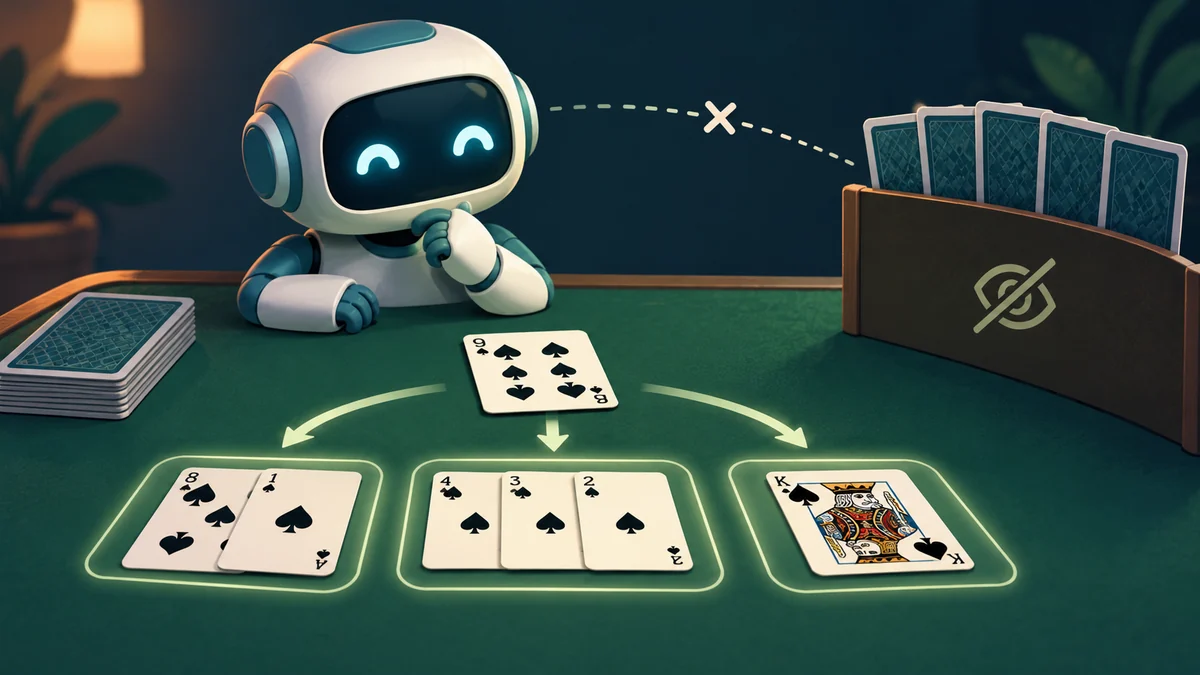
CountUnknownHigherCardsInSuit ترتیب RankOrderHighToLow را تا رتبهٔ کارت فعلی مرور میکنه و رتبههای قبلاً مشاهدهشده یا حاضر در دست خود بات را کنار میگذارد. این راه از اطلاعات عمومی و دست مجاز خود بات استفاده میکنه. OpponentYetToActCanTrump نیز صندلیهای هنوز بازینکرده را بررسی میکنه و فقط حریف دارای شاهد نپیروی از خال را همراه تخمین حکم باقیمانده تهدید میداند. اما این تخمین توزیع دقیق حکم میان صندلیها نیست؛ ممکنه حکمها در جای دیگری باشند. نتیجهٔ این متد باید نشانهٔ خطر خوانده بشه، نه اطلاع قطعی از دست پنهان.
فشار پایان دست نیز با دو تعریف مشخص وارد میشود: IsCloseScore رسیدن هر تیم به HandTargetTricks منهای یک را میسنجد و IsEndgame اندازهٔ دست را با EndgameHandSizeThreshold مقایسه میکنه. ScoreSupportDiscardCard برای عبور از شریک جریمه میگذارد و از مصرف حکم وقتی شریک جلو هست پرهیز میکنه. این سیاستها رفتار را قابل بحث میکنند، اما تعداد پارامترها هزینهٔ تنظیم و بررسی داره. وجود کلاس Advanced در فایلها نشاندهندهٔ قابلیت پیادهسازیشده؛ برای ادعای استفادهٔ فعال در هر صحنه باید مسیر ساخت و انتخاب استراتژی همان صحنه را جدا بررسی کرد.
چیزی که از این مرحله یاد گرفتم
برای من، هوشمندی قابل دفاع از تقسیم موقعیتها شروع میشود. حفظ کارت باارزش، حمایت از شریک و گرفتن دور سه هدف مرتبطاند، ولی در هر مرحله وزن یکسانی ندارند.
مثال عملی تصمیم تاکتیکی ربات حکم
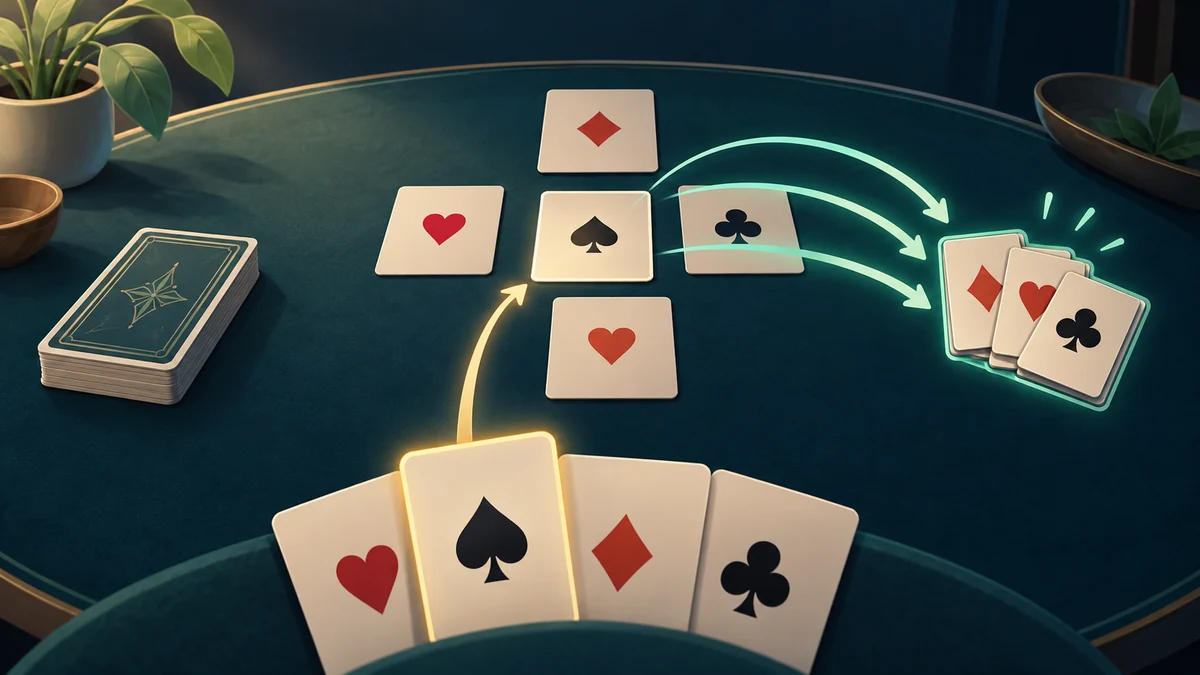
برای فهم عملی تصمیم تاکتیکی ربات حکم، یک مثال آموزشی را قدمبهقدم دنبال کنیم. همتیمی فعلاً برندهٔ دور است و ربات باید میان حفظ کارت قوی و گرفتن دور تصمیم بگیرد. پیش از اجرا، وضعیت آغاز را روی کاغذ بنویس؛ مشخص کن چه چیزی میتواند تغییر کند و چه چیزی باید ثابت بماند. بعد فقط همین مسیر را اجرا کن. این مثال گزارشی از آمار کاربران یا قابلیت تازهٔ منتشرشدهٔ دلو نیست؛ تمرینی برای روشن کردن تصمیم طراحی همین مطلب است.
خطای رایج و علت آن
قاعدهٔ همیشه بزرگترین کارت را بده، منابع دست را بدون توجه به وضعیت تیم مصرف میکند. این خطا معمولاً وقتی پنهان میماند که فقط مسیر موفق و ظاهر نهایی را ببینیم. برای پیدا کردن علت، آخرین وضعیت درست را از نخستین وضعیت نادرست جدا کن و ببین تغییر دقیقاً در کدام مرز رخ داده است. تصمیم تاکتیکی باید بر اطلاعات مجاز تکیه کند و تضمین برد قطعی نمیدهد. اگر این تفاوت در قرارداد مشخص نباشد، اصلاح یک نشانه ممکن است همان مسئله را در بخش دیگری دوباره ایجاد کند.
چطور نتیجه را بررسی کنیم؟
سناریوهای همتیمی جلو، حریف جلو و امکان بریدن را با گزینههای مجاز مقایسه کن. اجرای یکباره برای نتیجهگیری کافی نیست؛ یک بار مسیر معمول و بار دیگر همان موقعیت را با ورودی مرزی یا تکرار اقدام بررسی کن. اگر نتیجه فرق دارد، ورودی و شرایط اجرا را همراه خروجی نگه دار تا مقایسه قابل بازسازی باشد. جدول زیر خلاصهٔ مشخصات همین سناریو است و برای ثبت نتیجهٔ بررسی به کار میآید.
| بخش بررسی | آنچه باید ثبت شود |
|---|---|
| موقعیت آزمایشی | همتیمی فعلاً برندهٔ دور است و ربات باید میان حفظ کارت قوی و گرفتن دور تصمیم بگیرد. |
| ریسک اصلی | قاعدهٔ همیشه بزرگترین کارت را بده، منابع دست را بدون توجه به وضعیت تیم مصرف میکند. |
| روش بررسی | سناریوهای همتیمی جلو، حریف جلو و امکان بریدن را با گزینههای مجاز مقایسه کن. |
| مرز نتیجهگیری | تصمیم تاکتیکی باید بر اطلاعات مجاز تکیه کند و تضمین برد قطعی نمیدهد. |
پرسشهای کاربردی دربارهٔ تصمیم تاکتیکی ربات حکم
از کجا شروع کنم؟
از همان موقعیت محدود این مطلب شروع کن: همتیمی فعلاً برندهٔ دور است و ربات باید میان حفظ کارت قوی و گرفتن دور تصمیم بگیرد. ابتدا نتیجهٔ مورد انتظار را مشخص کن و بعد سراغ پیادهسازی یا ابزار برو. وقتی مسیر پایه قابل توضیح و بررسی شد، میتوان حالتهای بیشتری اضافه کرد. ساخت همهٔ حالتها از ابتدا، فهم علت خطا را سختتر میکند.
چه زمانی میتوانم بگویم این بخش درست کار میکند؟
زمانی که رفتار در موقعیت تعریفشده با قرارداد سازگار باشد و محدودیتهای آن روشن بمانند. سناریوهای همتیمی جلو، حریف جلو و امکان بریدن را با گزینههای مجاز مقایسه کن. موفقیت در این آزمون دربارهٔ همان سناریو شاهد میدهد؛ از آن نمیتوان بدون بررسی دربارهٔ همهٔ دستگاهها، همهٔ قوانین محلی یا همهٔ حجمهای داده نتیجه گرفت. تصمیم تاکتیکی باید بر اطلاعات مجاز تکیه کند و تضمین برد قطعی نمیدهد.
برای ادامهٔ همین موضوع، هستهٔ مشترک دلو؛ یک میز برای چند بازی و بازی دلو را ببین. زمینهٔ ساخت این پروژهها و معرفی سازنده در صفحهٔ کیان پاک نعمت آمده است.